Microsoft Down, Satu Dunia Susah Nak Buat Kerja. Terlalu Bergantung Pada Cloud Ke Kita?
Microsoft 365 tergendala hampir 24 jam. Apa yang mencetuskan gangguan itu, dan apa yang ia ajar kita tentang kebergantungan pada cloud?
Bayangkan kau buka laptop pagi Jumaat, bersedia nak sambung kerja. Outlook tak boleh buka e-mel. Kau cuba hubungi rakan sekerja melalui Teams, tapi sambungan pula bermasalah. Fail yang nak disemak tersimpan dalam SharePoint. Tiba-tiba, benda yang biasanya mengambil masa lima minit pun jadi susah.
Laptop kau tak rosak. Internet mungkin elok. Masalahnya berada di tempat lain, jauh daripada meja kerja kau.
Itulah yang menarik perhatian aku tentang gangguan Microsoft 365 pada 12 November 2026. Bukan semata-mata sebab syarikat sebesar Microsoft pun boleh mengalami downtime, tetapi sebab satu insiden teknikal mampu mengganggu begitu banyak urusan yang selama ini kita anggap biasa.
Apa sebenarnya yang berlaku kepada Microsoft?
Berdasarkan laporan Ars Technica yang merujuk laporan awal Microsoft, gangguan utama bermula pada 12 November, jam 4:20 petang UTC, dan berakhir pada 13 November, jam 4:10 petang UTC. Kalau ikut waktu Malaysia, itu bersamaan 12:20 pagi pada 13 November hingga 12:10 pagi pada 14 November. Hampir 24 jam.
Exchange Online, perkhidmatan yang mengendalikan e-mel untuk banyak organisasi, mengalami kesan paling ketara. Pengguna menghadapi masalah membuka mailbox melalui Outlook dan beberapa kaedah sambungan lain. Perkhidmatan seperti Teams, OneDrive, SharePoint dan Copilot turut terjejas, walaupun tahap kesan dan waktu pemulihannya tidak sama.
Kesannya bukan setakat orang tak dapat baca e-mel. Reuters melalui CNA melaporkan bahawa gangguan tersebut menjejaskan urusan perniagaan dan komunikasi, termasuk menyebabkan beberapa syarikat menangguhkan pengumuman keputusan kewangan mereka.
Rupanya bug tu dah ada sejak bulan Julai
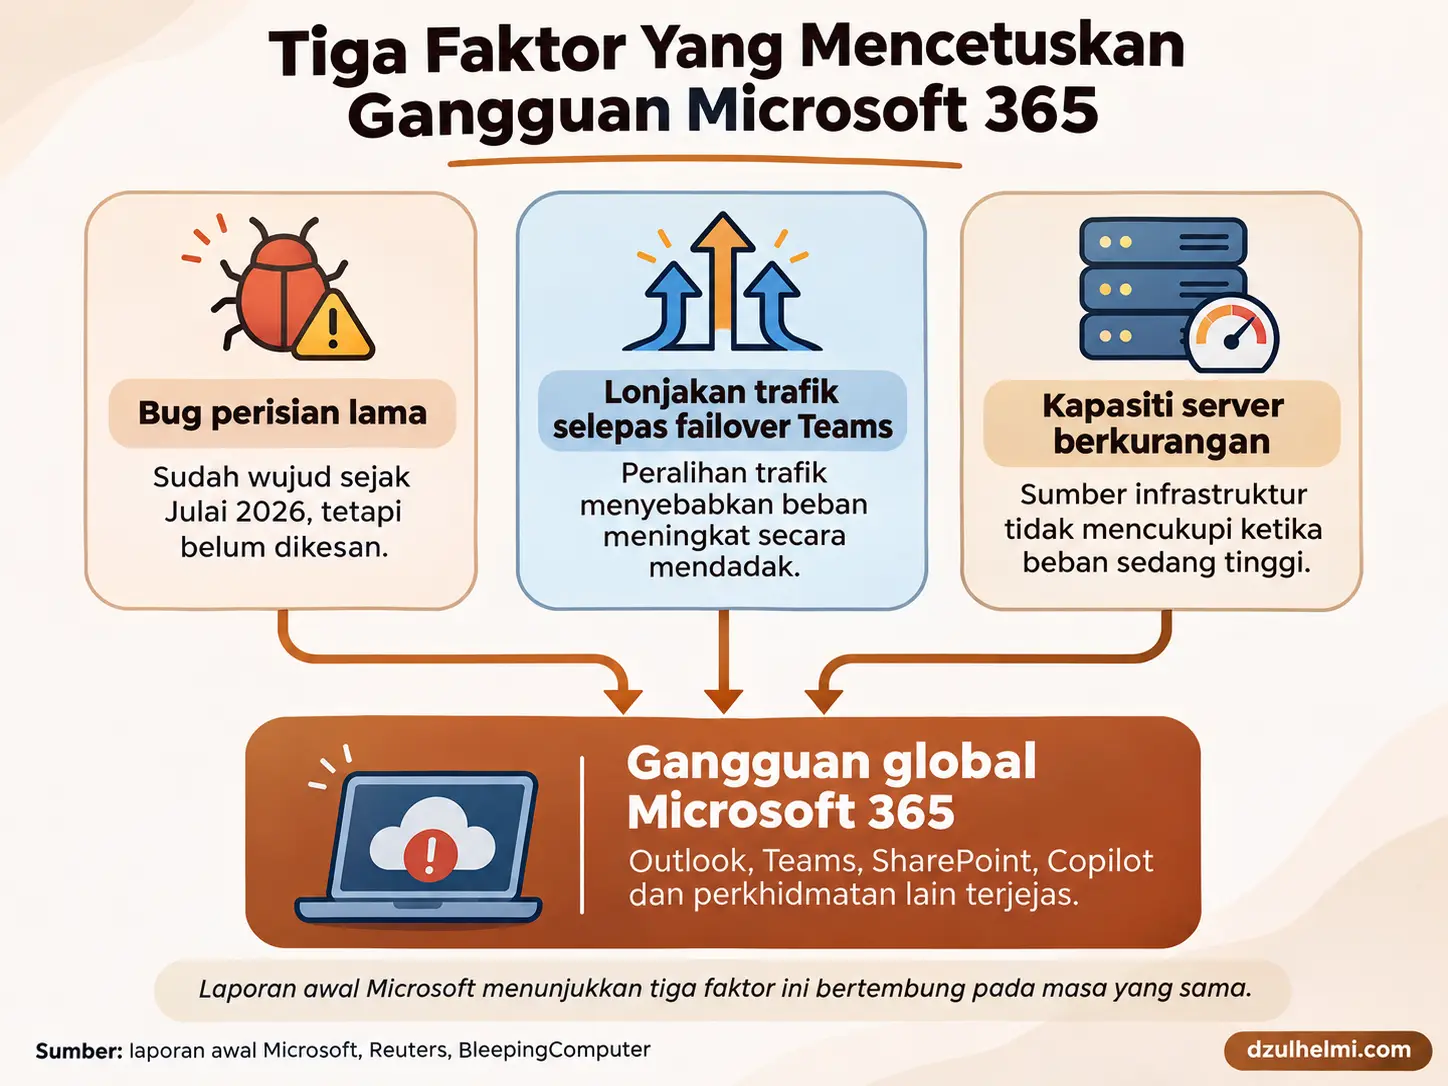
Apabila Microsoft mengeluarkan laporan awal insiden pada 16 November, gambaran puncanya menjadi lebih jelas. Menurut BleepingComputer dan The Verge, bukan satu masalah sahaja yang mencetuskan gangguan itu. Ada tiga faktor yang bertembung.
- Bug perisian lama. Perubahan yang mula diperkenalkan pada Julai 2026 mengandungi kecacatan tersembunyi. Dalam keadaan beban tertentu, sumber pemprosesan dan memori server boleh menjadi tepu sehingga server gagal memberi respons.
- Lonjakan trafik selepas failover Teams. Trafik Teams dialihkan daripada gateway alternatif ke gateway utama yang turut menyokong Exchange Online, menambah beban kepada laluan tersebut.
- Kapasiti server berkurangan. Sebahagian kapasiti gateway sudah tidak tersedia akibat masalah berasingan. Ruang untuk menyerap pertambahan trafik menjadi lebih kecil.
Cuba bayangkan lebuh raya yang tiba-tiba menerima lebih banyak kereta kerana trafik dari laluan lain dialihkan ke situ. Pada masa yang sama, beberapa lorong sudah ditutup. Kemudian sistem yang mengawal aliran trafik pula bermasalah apabila terlalu banyak kenderaan masuk.
Menambah kereta bukan semestinya menyebabkan kesesakan besar kalau semua lorong tersedia dan sistem berfungsi dengan baik. Tetapi apabila ketiga-tiga masalah berlaku serentak, kesannya boleh jadi jauh lebih besar.
Itu analogi mudah, bukan gambaran tepat seni bina Microsoft. Dan laporan tersebut masih laporan awal, jadi butiran teknikalnya boleh diperhalusi kemudian. Setakat maklumat yang ada, Microsoft tidak mengaitkan insiden ini dengan serangan siber.
Macam mana satu gangguan boleh menjejaskan banyak aplikasi?
Outlook dan Teams nampak macam dua aplikasi berasingan. Tapi di belakang skrin, kedua-duanya boleh berkongsi sebahagian infrastruktur yang diperlukan untuk berfungsi. Antaranya komponen yang mengurus sambungan pengguna, pengesahan identiti dan trafik rangkaian.
Kalau komponen yang dikongsi itu mengalami masalah, aplikasi yang bergantung padanya boleh turut menerima kesan. Dalam dunia IT, kegagalan yang merebak daripada satu bahagian kepada bahagian lain dipanggil cascading failure.
Sebab itu penyedia cloud lazimnya mempunyai redundancy, iaitu kapasiti atau laluan alternatif apabila komponen utama gagal. Proses mengalihkan beban kepada alternatif tersebut pula dipanggil failover.
Ironinya, failover sendiri boleh menambah tekanan pada sistem yang menerima beban jika kapasiti yang ada tidak mencukupi. Pengajaran daripada insiden ini bukan bahawa failover tak berguna. Sebaliknya, kita perlu memahami keadaan ketika sistem alternatif dipanggil untuk mengambil alih, termasuk kemungkinan beberapa masalah berlaku serentak.
Dulu kalau internet down, kita masih boleh buat kerja
Kalau fikir balik, cara kita bekerja dah banyak berubah. Dulu banyak dokumen disimpan dalam hard disk komputer. Word dan Excel boleh digunakan tanpa internet. Fail pejabat mungkin berada dalam server yang terletak di bangunan sendiri.
Sekarang kita boleh buka dokumen sama-sama dari rumah, pejabat atau ketika berada di luar negara. Tak perlu lagi hantar e-mel dengan attachment bernama final, final-v2 dan final-betul-betul-final. Kerjasama yang dulu menyusahkan menjadi jauh lebih mudah.
| Dulu | Sekarang |
|---|---|
| Dokumen dalam komputer | Dokumen dalam cloud |
| Perisian dipasang secara lokal | Aplikasi berasaskan SaaS |
| Fail dalam server pejabat | SharePoint, OneDrive, Google Drive |
| Mesyuarat bersemuka | Teams dan Google Meet |
| Banyak proses dilakukan sendiri | Automasi dan AI agents |
Tapi ada pertukaran yang datang bersama kemudahan itu. Bila dokumen, komunikasi, tugasan dan proses kelulusan bergantung pada perkhidmatan online, masalah di luar organisasi boleh menentukan sama ada kerja kita boleh diteruskan atau tidak.
Ini bukan bermakna zaman dahulu semuanya lebih baik. Hard disk pun boleh rosak. Server pejabat pun boleh down. Malah, sesetengah aplikasi cloud moden masih mempunyai fungsi offline. Bezanya ialah lokasi dan skala kebergantungan kita.
Masalah ini bukan Microsoft seorang
Bayangkan sebuah organisasi menggunakan perkhidmatan e-mel, storan dokumen, sistem login dan aplikasi perniagaan daripada ekosistem yang sama. Ada baiknya dari sudut integrasi dan pengurusan. Tetapi kalau komponen yang diperlukan oleh beberapa perkhidmatan mengalami masalah, kesannya mungkin sukar diasingkan.
Ini salah satu bentuk risiko pemusatan digital atau concentration risk. Apabila banyak organisasi mempunyai kebergantungan pada penyedia atau infrastruktur yang sama, insiden pada penyedia tersebut boleh memberi kesan merentasi organisasi.
Penggunaan AWS, Google Cloud, Azure atau perkhidmatan lain tidak secara automatik menghapuskan risiko ini. Sebuah aplikasi mungkin dihoskan oleh satu syarikat tetapi masih menggunakan sistem identiti atau perkhidmatan rangkaian daripada syarikat lain.
Kita selalu bercakap tentang cloud seolah-olah ia sesuatu yang tidak mempunyai lokasi fizikal. Sebenarnya, ia tetap bergantung pada komputer, pusat data, bekalan elektrik, sistem penyejukan dan rangkaian komunikasi. Dalam artikel sebelum ini, aku ada membincangkan pertumbuhan data center di Malaysia dan persoalan penggunaan airnya. Isu kali ini memperlihatkan satu lagi sisi infrastruktur yang sama: apa berlaku apabila perkhidmatan yang kita perlukan tak dapat diakses?
Cloud tak bagus ke kalau macam ni?
Bukan itu kesimpulan yang patut kita ambil. Cloud memberi banyak kelebihan, termasuk akses dari pelbagai lokasi, kapasiti yang boleh ditambah mengikut keperluan dan pengurusan infrastruktur yang tidak perlu ditanggung sepenuhnya oleh setiap organisasi.
Untuk organisasi kecil khususnya, membina dan menjaga infrastruktur sendiri bukan perkara murah. Nak menyediakan server kedua, sambungan internet alternatif, backup, pemantauan keselamatan dan pasukan yang boleh bertindak apabila berlaku masalah pun memerlukan masa serta kos.
Memindahkan semuanya keluar daripada cloud juga tidak semestinya menjadikan sistem lebih reliable. Yang lebih penting ialah memahami kegagalan mana yang boleh berlaku, berapa lama kita mampu bertahan dan apa alternatif yang benar-benar boleh digunakan.
Kalau esok cloud down lagi, kita dah bersedia?
Tak semua orang perlu menyediakan sistem backup canggih atau menggunakan lima penyedia cloud. Tapi ada beberapa perkara yang boleh kita fikirkan, bergantung pada betapa pentingnya perkhidmatan tersebut kepada kerja kita.
- Sediakan akses offline. Kenal pasti dokumen yang diperlukan untuk meneruskan kerja ketika internet atau perkhidmatan cloud bermasalah. Simpan salinan hanya jika polisi keselamatan organisasi membenarkannya.
- Ada saluran komunikasi alternatif. Tentukan cara menghubungi pasukan ketika e-mel dan aplikasi chat utama gagal. Gunakan saluran yang diluluskan untuk maklumat kerja.
- Bezakan sync dengan backup. Fail yang diselaraskan antara komputer dan cloud tidak semestinya mempunyai salinan bebas yang boleh dipulihkan. Semak polisi retention dan uji proses pemulihan.
- Kenal pasti sistem kritikal. Senaraikan operasi yang tidak boleh menunggu sehari serta sistem lain yang diperlukan untuk menjalankannya, termasuk sistem login.
- Uji pelan kesinambungan operasi. Jangan sekadar simpan dokumen Business Continuity Plan dalam folder SharePoint yang mungkin tak boleh diakses ketika diperlukan.
- Fahami SLA. Janji tahap ketersediaan bukan jaminan bahawa perkhidmatan tidak akan pernah down. Semak apa yang dilindungi dan bagaimana organisasi perlu bertindak apabila berlaku gangguan.
Bagi organisasi yang lebih besar, menggunakan penyedia tambahan mungkin membantu mengurangkan sesetengah risiko. Tetapi strategi itu juga menambah kos, kerumitan dan keperluan kepakaran. Kalau kedua-dua sistem masih bergantung pada perkhidmatan login yang sama, misalnya, sebahagian risiko tetap dikongsi.
Teknologi memudahkan kita, tapi jangan lupa kebergantungannya
Aku rasa insiden Microsoft ini menarik sebab ia menunjukkan bagaimana sesuatu yang jarang kita fikirkan boleh menjadi sangat penting apabila ia gagal. Biasanya kita hanya buka aplikasi dan mengharapkan semuanya berfungsi. Infrastruktur di belakangnya tak nampak, sehinggalah satu hari kita tak dapat masuk.
Kita tak perlu berhenti menggunakan cloud. Kemudahan yang diberikannya memang nyata. Cuma mungkin sudah sampai masa kita lebih sedar apa yang kita serahkan kepada perkhidmatan tersebut, dan menyediakan sedikit ruang untuk terus berfungsi apabila ia tergendala.
Kalau esok semua perkhidmatan cloud utama yang kau gunakan tiba-tiba down selama 24 jam, berapa banyak kerja yang kau masih boleh buat?
Sumber dan nota kajian
- Ars Technica: Laporan tiga faktor gangguan Microsoft 365.
- Reuters melalui CNA: Kesan gangguan kepada pengguna dan perniagaan.
- BleepingComputer: Bug perisian lama dan punca gangguan Microsoft 365.
- The Verge: Penjelasan teknikal gangguan Outlook.
- Deutsche Welle: Microsoft tidak mengaitkan gangguan dengan aktiviti berniat jahat.
Nota editorial: Perincian punca dan tempoh gangguan dalam artikel ini merujuk laporan awal Microsoft seperti dilaporkan oleh sumber di atas. Tempoh gangguan utama tidak bermakna semua pengguna atau perkhidmatan terjejas sepanjang tempoh yang sama. Perbincangan tentang risiko kebergantungan cloud dan kesinambungan operasi ialah analisis editorial, bukan dapatan kajian empirikal. Featured image dan diagram ialah ilustrasi janaan AI, bukan dokumentasi visual insiden sebenar.
Untuk yang baru nak mula
Nak Belajar WordPress?
Aku ajar dari zero.